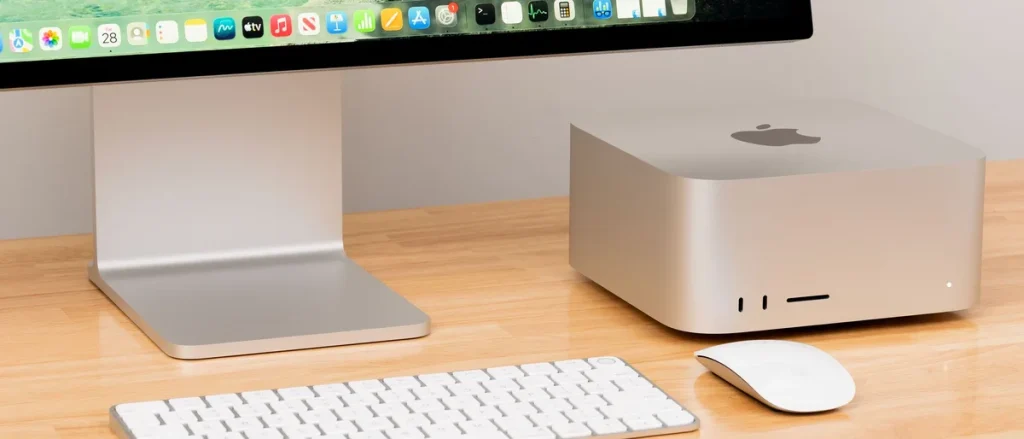
Mac Studio M5 Ultra с 256 ГБ объединённой памяти выполнил агентный тест AgentPerf-Local почти вдвое быстрее одиночной системы уровня Nvidia DGX Spark и потратил примерно на 16% меньше энергии на задачу. Но для запуска самых тяжёлых открытых моделей преимущество Apple быстро упирается не в железо, а в зрелость софта — важный нюанс для команд, которые выбирают дорогую рабочую станцию под локальный ИИ.
Сравнение провело издание Tom's Hardware. Его тестовая конфигурация Mac Studio с 36-ядерным CPU, 80-ядерным GPU и 256 ГБ памяти стоит от $12,3 тыс.; близкий по классу Dell Pro Precision GB10 с 4-ТБ SSD оценён примерно в $10 тыс. Разрыв между ценами уже не выглядит фантастическим, хотя ещё недавно Apple-машину такого уровня было проще списать в категорию «слишком дорого для экспериментов».
В AgentPerf-Local обе системы запускали плотную модель Qwen 3.8 27B через llama.cpp с включённым multi-token prediction. Бенчмарк воспроизводит записанные трассы агентных сценариев, причём значительная часть нагрузки приходится на обработку входного контекста, а не на генерацию очередного токена. Mac Studio M5 Ultra закончил фиксированный объём работы чуть менее чем за половину времени одиночного GB10. По произведению времени на энергопотребление — метрике energy-delay product — результат Mac оказался менее половины показателя соперника.
На бумаге это объяснимо: у M5 Ultra заявлена пропускная способность памяти 1,2 ТБ/с, тогда как у GB10 в тесте — 273 ГБ/с. Для декодирования токенов память часто важнее красивого числа вычислительных блоков в спецификации. Но именно этот тест хорошо показывает и более неприятную для закупщика истину: локальный инференс нельзя выбирать только по количеству ядер, гигабайтам памяти или пиковой производительности. Одна и та же модель меняет расстановку сил вместе с движком инференса, квантизацией и рецептом запуска.
Это стало заметно на моделях, ради которых вообще имеет смысл смотреть на 256 ГБ памяти: GLM-5.3 Flash и DeepSeek V4.1 Flash 1017. Mac Studio M5 Ultra способен разместить их локально в квантизированном виде: GLM — в четырёхбитном варианте, DeepSeek — в двухбитном. Один DGX Spark с 128 ГБ памяти этого не позволяет, зато платформа Nvidia поддерживает объединение двух систем в кластер. Такой комплект с накопителями на 4 ТБ, по оценке авторов, обойдётся примерно в $15–20 тыс. и выше.
С DeepSeek преимущество оказалось у пары Spark. На Apple Silicon пришлось использовать llama.cpp: в памяти не осталось места одновременно для весов модели и отдельной модели DSpark, нужной для спекулятивного декодирования. Кластер Nvidia, напротив, получил и DSpark, и движок TensorFold. В результате обработка самых длинных контекстов занимала у Mac от 10 до 25 минут, а у двух Spark — не более пяти минут. Для разработчика, который гоняет длинные документы, репозитории или логи через локального агента, это не синтетическая мелочь, а разница между рабочим циклом и кофейной паузой.
С GLM-5.3 Flash картина сложнее. В llama.cpp кластер Spark всё равно быстрее обрабатывал промпты, хотя Mac благодаря высокой пропускной способности памяти выдавал больше токенов в секунду на этапе декодирования. Зато TensorFold доступен и для Apple Silicon с четырёхбитной версией GLM. После перехода на этот рецепт Mac заметно сократил отставание в обработке контекста, а скорость декодирования выросла в среднем втрое относительно llama.cpp.
Практический вывод для российского рынка локального ИИ довольно приземлённый. Если нужны компактная тихая рабочая станция, быстрый CPU для обычной разработки и стабильная производительность на популярных моделях умеренного размера, Mac Studio M5 Ultra выглядит сильным вариантом. Он особенно интересен небольшим командам, которым важно хранить данные локально и не собирать отдельный сервер из GPU, сетевых компонентов и системы охлаждения.
Но покупка устройства за пятизначную сумму исключительно под большие LLM требует предварительной проверки конкретного стека. Для DeepSeek V4.1 Flash 1017 у Nvidia уже есть кластерный сценарий с более зрелой поддержкой, тогда как потенциал Apple пока зависит от того, успеет ли сообщество подготовить быстрый рецепт запуска. Экосистема CUDA и Nvidia традиционно быстрее подхватывает новые веса после публикации, а MLX и совместимые с Apple Silicon движки ещё догоняют по покрытию моделей.
Главный вопрос теперь не в том, способна ли Apple конкурировать с DGX Spark по «железной» скорости: в подходящем сценарии она это уже делает. Вопрос в том, насколько быстро MLX, TensorFold и другие инструменты превратят пропускную способность M5 Ultra в предсказуемый результат для каждой новой крупной модели. Пока для универсальной локальной ИИ-платформы Nvidia предлагает больше гарантий совместимости, а Mac Studio M5 Ultra — более убедительную производительность там, где программная часть уже успела за чипом.