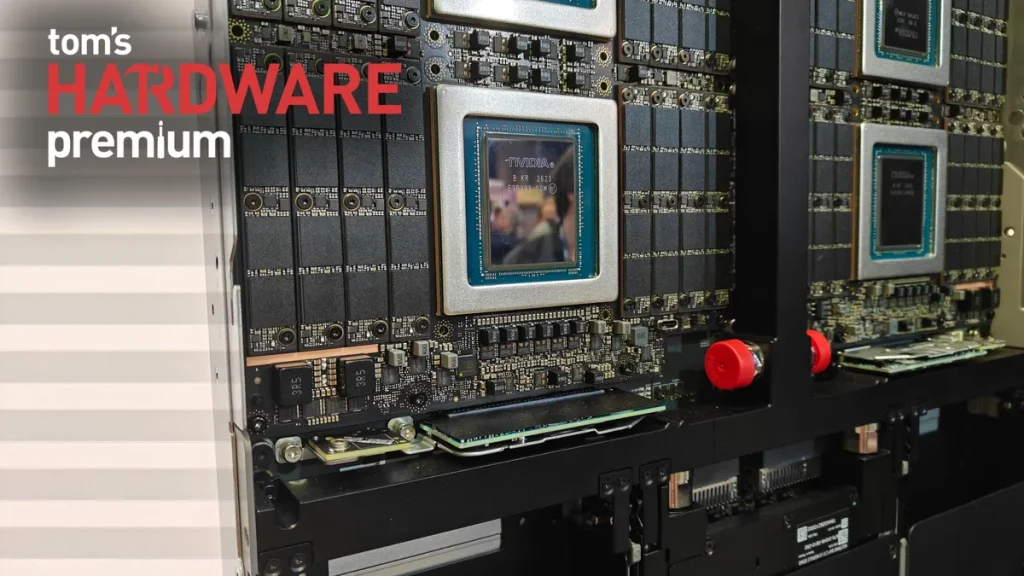
Процессор Nvidia Vera начали проектировать около четырёх лет назад, когда нынешний ажиотаж вокруг ИИ-агентов ещё не был сформулирован как отдельный рынок. Руководитель CPU-направления Nvidia Иан Файндер прямо сказал, что приписывать компании предсказание этого тренда «абсурдно», однако именно Vera должна стать важным элементом инфраструктуры для агентных систем — особенно там, где CPU приходится обслуживать множество быстро меняющихся сред выполнения рядом с GPU.
Об этом Файндер рассказал в беседе с Tom's Hardware. Его комментарий стал ответом на критику со стороны AMD: конкуренты сомневаются, что Nvidia или Arm могли несколько лет назад целенаправленно создать «агентный» процессор. Nvidia не отрицает очевидное: магического шара у инженеров не было. Вместо этого компания объясняет архитектуру Vera более приземлённо — её проектировали вместе с ускорителями, исходя из того, что дата-центры будут всё сильнее зависеть от ускоренных вычислений.
Логика здесь не про замену GPU процессорами. Напротив, агентные приложения делают связку CPU и GPU плотнее. Языковая модель выполняет инференс на ускорителе, но между запросами ей нужно читать файлы, вызывать инструменты, запускать изолированные окружения, собирать код и гонять тесты. Часть этих операций короткая, часть тяжело нагружает CPU. Если на узле не хватает процессорных ресурсов, дорогие GPU не обязательно простаивают — их могут переключить на другую задачу, — но пропускная способность всей системы всё равно упирается в организацию хостовой стороны.
Именно поэтому Nvidia делает акцент не на максимальной частоте, а на производительности за такт, параллелизме, задержках доступа к памяти под нагрузкой и её пропускной способности. По словам Файндера, при проектировании с «чистого листа» не приходится в той же мере оглядываться на экономику стоимости одного ядра и требования большой установленной базы. Для производителей обычных серверных CPU это не комплимент, а довольно прозрачный укол: Intel и AMD вынуждены поддерживать широкий спектр традиционных корпоративных нагрузок, тогда как Nvidia может точнее подстроить чип под собственную AI-платформу.
У Vera эта специализация выражается в двух частях. Предыдущее поколение Grace принесло Scalable Coherency Fabric — систему когерентности памяти, рассчитанную на тесную работу процессора и ускорителей. Vera развивает этот подход и добавляет собственное ядро Olympus. Файндер называет архитектуру «предвзятой» в хорошем инженерном смысле: она сознательно оптимизирована под определённую модель дата-центра, а не пытается одинаково убедительно выглядеть во всех бенчмарках.
Это важная оговорка. Vera уже не выглядит безусловным лидером во всех тестах: Tom's Hardware указывает, что AMD EPYC Venice вернул лидерство в ряде сценариев. Но Nvidia рассчитывает, что преимущество по работе с памятью станет заметнее по мере развития агентных платформ. На раннем этапе многие такие системы пока используют вычислительные ресурсы не слишком экономно: окружения для агента создаются и уничтожаются с заметными накладными расходами, а CPU и память оказываются распределены не лучшим образом.
Следующая инженерная задача — запускать и останавливать изолированные sandbox-окружения за миллисекунды, а затем уплотнять их на одном сокете. Файндер приводит знакомый разработчикам пример coding agent: после промпта модель делает несколько небольших вызовов для поиска и чтения файлов, затем запускает компиляцию и тесты. В момент сборки нагрузка смещается на CPU. Если одновременно обслуживать много таких агентов, на процессор приходится больше параллельных сред, а на память — больше обращений. Стартапы Daytona и E2B как раз работают над быстрым жизненным циклом таких сред.
Для российских команд, строящих внутренние AI-платформы или сервисы разработки с агентами, вывод скорее архитектурный, чем закупочный. Бюджет на GPU сам по себе не гарантирует высокую производительность агентных сценариев. Нужно учитывать количество CPU-ядер, память, скорость старта контейнеров или виртуальных сред, очереди задач и то, как планировщик делит ресурсы между агентами. Иначе ускорители будут заняты полезной работой, но пользователи всё равно увидят медленные сборки, задержки при запуске инструментов и узкие места в файловой системе.
При этом Nvidia пока продаёт не готовый ответ на проблему, а ставку на её будущую форму. Компания уже анонсировала следующий CPU Rosa с микроархитектурой Rigel, а процессор Nvidia Vera должен доказать, что высокая пропускная способность памяти и тесная интеграция с ускорителями важнее универсальности в быстрорастущем сегменте. Главный вопрос теперь не в том, угадала ли Nvidia термин «агентный ИИ», а в том, смогут ли платформы научиться эффективно уплотнять агентные среды раньше, чем конкуренты предложат более универсальную альтернативу. Подробнее о позиции компании — в материале .