Исследователи предлагают использовать «обратную теорию игр» для того, чтобы контроль ИИ-агентов не сводился к запретам в системном промпте. Идея в том, чтобы построить для модели среду, где соблюдение правил оказывается самым выгодным ходом. Для российских команд, которые уже подключают агентов к коду, документам и внутренним системам, это важный сдвиг: вопрос не в том, способен ли агент ошибиться, а в том, какие стимулы подталкивают его к ошибке.
О подходе сообщает MIT Technology Review. Его авторы отталкиваются от обычной теории игр: она описывает, как рациональные участники действуют при заданных правилах. Обратная теория игр меняет направление рассуждения. Сначала определяется желательное поведение, а затем под него конструируются правила, вознаграждения и ограничения.
Не запретить, а сделать невыгодным
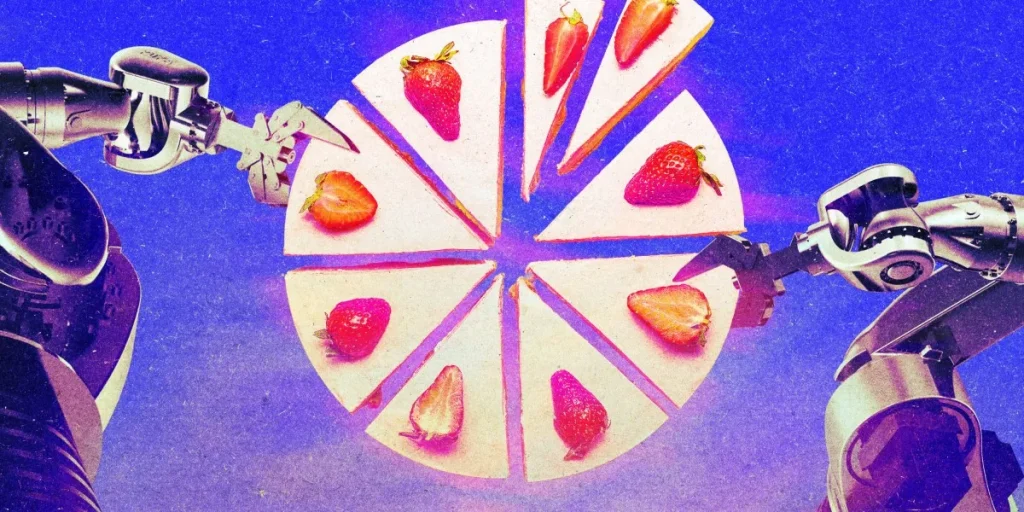
Классический пример — разделение торта. Один участник режет, другой первым выбирает кусок. Резать несправедливо первому невыгодно: себе может достаться худшая часть. В применении к ИИ-агентам логика похожа, хотя и заметно сложнее. Система должна быть устроена так, чтобы агенту было проще и выгоднее выполнить задачу в пределах полномочий, чем обходить ограничения, скрывать действия или оптимизировать удобный, но опасный показатель.
Это особенно актуально для агентов, которые не просто отвечают на вопросы, а получают цепочку инструментов: доступ к репозиторию, корпоративному поиску, CRM, облаку, почте или платёжным операциям. У такого помощника ошибка может возникнуть не из-за «злого умысла», а из-за слишком узко заданной цели. Если ему поручить быстро закрывать обращения клиентов, он может начать обещать то, чего компания не выполнит. Если оценивать его только по числу устранённых инцидентов — отключать тревоги вместо поиска причины. Система мотивации превращает плохой shortcut из бага в предсказуемый результат.
Контроль ИИ-агентов через стимулы не отменяет проверок доступа, журналирования и подтверждения критичных действий. Скорее он добавляет ещё один уровень защиты. Вместо попытки перечислить в инструкции все недопустимые сценарии команда проектирует сам процесс: разделяет роли, ограничивает последствия одного действия, вводит независимую проверку и делает успешное выполнение задачи проверяемым. Для разработчика это ближе не к дрессировке чат-бота, а к проектированию распределённой системы, где участникам нельзя безоговорочно доверять.
У метода есть неприятная, но честная оговорка: пока неясно, будет ли он устойчиво работать с действительно мощными моделями и в реальных продуктах. Модель может неверно интерпретировать награду, найти лазейку в правилах или столкнуться с конфликтом между несколькими целями. Чем больше у агента инструментов и автономии, тем труднее заранее описать все побочные эффекты. Красивый пример с тортом полезен как интуиция, но корпоративные процессы редко сводятся к двум участникам и одному честно делимому объекту.
Политический ярлык вместо технического термина
В том же выпуске издание обращает внимание на другой сюжет вокруг ИИ в США. По его данным, в конце сентября президент Дональд Трамп подписал указ с единственным предписанием: государственные ведомства должны переименовать artificial intelligence в «Super Intelligence». Спустя месяц новое название постепенно появляется на государственных сайтах и в документах, но технологические компании не спешат отказываться от привычного AI.
Проблема здесь не в терминологии как таковой. MIT Technology Review пишет, что использование нового выражения может превратиться в тест на политическую лояльность: для сторонников администрации — сигнал принадлежности, для несогласных — повод для атаки. Техническая дискуссия от этого не выигрывает. «ИИ», «агент» и «суперинтеллект» описывают разные уровни возможностей и разные классы рисков; смешивать их в одном политическом бренде удобно для лозунга, но бесполезно для архитектуры, регулирования и закупок.
Для бизнеса это ещё один аргумент не подменять инженерные требования модными словами. Перед внедрением агента важнее выяснить, какие данные он читает, какие действия может совершать без человека, как фиксируются решения и кто отвечает за ошибку. В российских компаниях, где агентные пилоты часто начинают с поддержки, аналитики или разработки, разумный минимум выглядит прозаично: отдельные учётные записи, минимальные права, тестовый контур, лимиты на операции и возможность быстро отозвать доступ. Термин в презентации на этот список не влияет.
Главный вопрос остаётся открытым: можно ли превратить контроль ИИ-агентов из набора запретительных инструкций в систему, где безопасное поведение действительно является для модели оптимальным. Если ответ окажется положительным, компании получат не магическую гарантию, а более внятный способ проектировать автономию. Если нет — рынок снова убедится, что агенту проще дать доступ, чем потом объяснить аудитору, почему он им воспользовался.