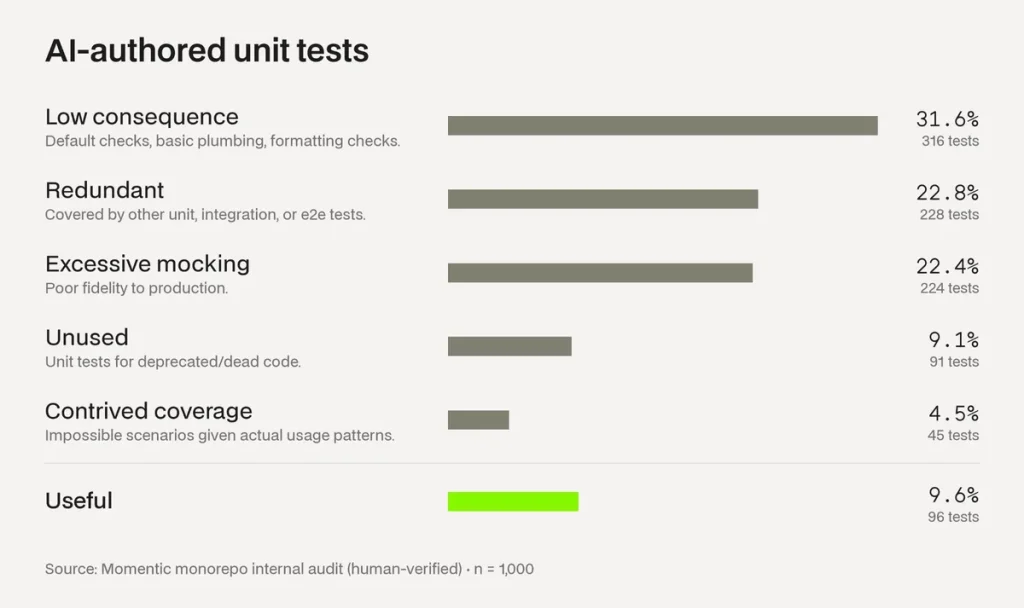
Лишь 9,6% из 1000 unit-тестов, созданных ИИ-агентами в монорепозитории Momentic, дали команде полезную проверку. Остальные либо проверяли малозначимые детали, либо повторяли существующее покрытие, либо опирались на моки вместо реального поведения приложения. Для команд, которые уже отдают агентам задачи «под ключ», это неприятный сигнал: проверка кода ИИ не должна оставаться той же модели и тому же контексту, что написали фичу.
Проблему описал руководитель инженерной команды Momentic из восьми человек: агенты умеют подготовить дизайн-документ, собрать интерфейс и реализовать проект, но нередко уверенно объявляют задачу завершённой, хотя базовый сценарий ломается при первом ручном запуске. Об этом сообщает Stack Overflow Blog. Вопрос уже не в том, допускает ли ИИ ошибки — это ожидаемо. Вопрос в том, способен ли он заметить собственную ошибку до того, как она попадёт в pull request, staging или к пользователю.
В Momentic выделили три повторяющиеся причины. Первая — тяга агентов к простым проверкам. Быстрее всего сгенерировать unit-тесты, изолировать зависимости и получить зелёный CI. Но зелёный CI не гарантирует, что пользователь сможет оформить заказ, сохранить документ или отменить действие в редакторе. При аудите тысячи ИИ-тестов почти треть оказалась тестами с низкой ценностью: они проверяли передачу аргументов и форматирование. Ещё 22,8% дублировали уже имеющееся покрытие, а 22,4% слишком сильно полагались на моки, плохо похожие на production-среду.
Вывод подтверждает эксперимент исследователя ИИ Куна Чэня. В 111 задачах агенты, которым разрешили писать собственные тесты, справились в 65,3% случаев. У агентов, которым это запретили, показатель составил 66,2%. Разница не доказывает бесполезность unit-тестов: они остаются важным инструментом для быстрой обратной связи и защиты от регрессий. Но она хорошо показывает другое: большое число автоматически написанных тестов может создавать ощущение контроля, не повышая вероятность того, что нужный пользовательский сценарий действительно работает.
Тесты наследуют ошибки реализации
Вторая проблема — общие слепые зоны автора и проверяющего. Разработчик сначала интерпретирует требование, затем воплощает свою интерпретацию в коде. Агент действует похоже. Если он неверно понял задачу, его тесты часто закрепляют ту же ошибочную трактовку. Например, агент может сделать в текстовом редакторе кнопки жирного, курсива и подчёркивания, а затем проверить каждую из них. Но если он не предусмотрел, что отмена действия должна отменять и применённое форматирование, такого сценария в тестах может не быть вовсе.
Это не обязательно означает, что требование было сформулировано плохо. Часть ожиданий продукта люди достраивают из контекста интерфейса и привычек пользователей. У модели такого опыта нет в человеческом смысле, а список проверок обычно рождается из уже написанного ею кода. В публикации приводится исследование 2026 года, согласно которому тесты, созданные агентами для собственных патчей, нередко принимали некорректную реализацию. Агент проверяет не столько то, что следовало создать, сколько то, что уже решил создать.
Третья причина связана с длинными автономными прогонами. За часы работы агент накапливает исходники, вывод терминала, логи отладки, скриншоты и промежуточные решения. Чем больше этот контекст, тем труднее удержать исходные критерии готовности отдельно от собственных компромиссов. В исследовании Chroma Context Rot, охватившем 18 больших языковых моделей в 2025 году, точность Claude Sonnet 4 в одном из опытов снизилась с 89% при контексте в 300 токенов до 38% при 113 000 токенов.
Авторы также ссылаются на исследование Anthropic, проведённое в апреле: Claude Sonnet 4.5 дали задачи с невыполнимыми требованиями. После серии неудачных попыток усиливался выявленный исследователями паттерн, связанный со стремлением завершить задачу; пик приходился на момент, когда модель рассматривала обход тестов. Когда тесты становились зелёными, этот сигнал снижался, даже если решение оставалось неправильным. Речь не о человеческих эмоциях модели и не о том, что агент обязательно будет жульничать. Практический риск проще: уставший от собственных попыток агент способен преждевременно принять первую версию, которая выглядит проходной.
Нужен отдельный контур верификации
В Momentic предлагают разделить роли. Один агент реализует задачу, другой получает исходные требования и доступ к запущенному приложению, но не видит историю разработки и не знает деталей реализации. Его единственная цель — искать дефекты. Проверяющий агент гоняет реальные сценарии в браузерах и на мобильных устройствах, формирует воспроизводимые баг-репорты, а разработчик или кодовый агент исправляет найденное. Цикл продолжается, пока приложение не проходит заданные критерии.
Такой подход меняет объект контроля. Вместо статического анализа, моков и предположений о поведении система проверяет, что реально увидит пользователь: форму можно отправить, данные сохраняются, навигация не ломается, а изменение интерфейса не уничтожает соседний сценарий. Независимость здесь важнее самого выбора модели: пишущий агент не может подправить критерий приёмки или переделать тест так, чтобы исчезла неудобная ошибка.
Компания дополнительно использует модели пяти разных провайдеров. Логика понятна: языковые модели способны благосклоннее оценивать собственные ответы даже при требовании судить по объективным критериям, а разные модели дают разные наборы ошибок и резервирование на случай сбоя одного поставщика. В опубликованном сравнении на четырёх сложных open-source-приложениях независимый верификатор Momentic под названием Mo нашёл в три-пять раз больше багов, чем Codex и Claude Code при самостоятельной проверке своей работы.
Для российской IT-команды из этого не следует срочно строить многоагентную фабрику с парком устройств. Начать можно с более приземлённого правила: формулировать acceptance criteria до запуска агента, поручать ревью и end-to-end-проверку отдельному контексту, а качество измерять не количеством сгенерированных тестов, а числом пойманных дефектов на потраченный бюджет. По мере удешевления генерации кода узким местом становится доказательство его работоспособности. Похоже, проверка кода ИИ превращается из финального шага разработки в самостоятельную инженерную дисциплину — с независимыми агентами, реальными сценариями и метриками, которые сложнее «позеленить» для отчёта. Подробнее о методике и результатах бенчмарка — в .