В октябре свыше четверти запросов через AI-роутер Vercel пришлась на модели принятия решений, а не на обычные LLM. Британский стартап Sqwish Labs считает, что следующий конкурентный рубеж здесь — не очередной общий бенчмарк, а возможность дообучать такие модели на собственных производственных данных компании. Для российских команд это знакомый сигнал: ценность AI всё чаще определяется не красивым демо, а тем, насколько предсказуемо система работает в конкретном процессе.
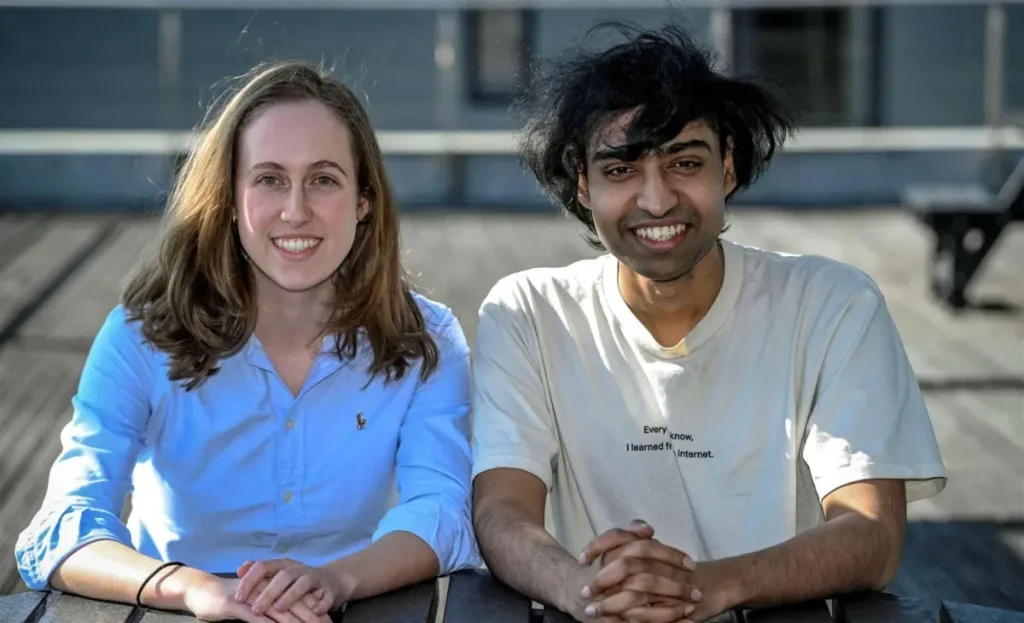
Sqwish Labs объявила о pre-seed раунде на $3 млн и развивает модель kettei fat. Её создатели — Ушниш Сенгупта и Федерика Фредди, познакомившиеся во время учёбы в Кембридже. Как сообщает TechCrunch, основатели занимались компактными LLM, но после появления семейства Jev от TypeSafe переориентировали свою архитектуру на более узкую задачу: выбирать один из заранее заданных вариантов и сообщать уверенность в выборе.
Это важное отличие от привычного чат-бота. Модель решений не генерирует длинный ответ и не объясняет ход мысли пользователю. Ей можно передать, например, набор обращений в поддержку и набор маршрутов: закрыть автоматически, передать биллингу, отправить в службу безопасности или эскалировать оператору. На выходе — вариант маршрутизации и оценка уверенности. Такая схема полезна там, где лишние секунды задержки и стоимость генерации текста важнее литературных способностей модели: в модерации, антифроде, классификации заявок, приоритизации инцидентов и работе с документами.
В Sqwish делают ставку на постобучение. Клиент загружает собственные данные из продакшена, а модель продолжает улучшать суждения именно на задачах этого клиента. Сенгупта называет это главным отличием от товарного продукта: стартап предлагает заказчикам тот же механизм улучшения, который использует для базовой модели. В теории это решает типичную проблему универсальных классификаторов: модель неплохо выглядит на усреднённом тесте, но путается в местных названиях продуктов, внутренних статусах, специфике договоров и исключениях, на которых держится реальный бизнес-процесс.
Рынок быстро заполняется. Jev помогла TypeSafe вырасти до оценки $7,5 млрд, а за последнюю неделю сервис OpenRouter обработал более 1,5 млрд запросов к моделям компании. После успеха Jev появились десятки аналогов: по данным источника, один инженер Amazon собрал собственную модель решений за выходные, затем варианты начали выпускать крупные облачные игроки. Microsoft также объявила о широком развёртывании Microsoft-Decision-1.1 в Azure.
У гиперскейлеров здесь есть очевидное преимущество в инфраструктуре, дистрибуции и доступе к корпоративным заказчикам. Но сама задача не сводится к тому, чтобы сделать самый большой классификатор. Диого Алмейда, глава TypeSafe, говорил TechCrunch, что самым сложным в разработке Jev была тонкая калибровка суждений на статистически скорректированных синтетических данных. Иными словами, модели недостаточно часто угадывать правильный вариант: она должна корректно понимать, когда уверена, а когда лучше вернуть задачу человеку или более дорогой модели.
Именно поэтому публичные таблицы лидеров здесь дают неполную картину. У Sqwish есть хорошие результаты на отдельных тестах, но в компании прямо говорят, что бенчмарк должен лишь подтолкнуть разработчика к пробе модели в собственном сценарии. Ахинт Шривастава, инженерный вице-президент Microsoft, сформулировал ту же мысль жёстче: модели, оптимизированные под бенчмарки, быстро проваливаются в реальном корпоративном использовании. Для команды, внедряющей AI, полезнее измерять не абстрактную точность, а долю верных маршрутизаций, число опасных ошибок, задержку, цену запроса и качество калибровки уверенности.
Практический вывод для разработчиков и продактов: модели принятия решений разумно рассматривать как отдельный слой системы, а не как дешёвую замену универсальной LLM. Быстрый классификатор может отсеивать типовые случаи, выбирать инструмент, определять приоритет или решать, нужен ли вызов большой модели. Сложные и неоднозначные запросы стоит передавать дальше — человеку либо более мощной генеративной модели. Такой каскад снижает стоимость и задержку, но требует дисциплины: версионирования данных, контрольной выборки, порогов уверенности и мониторинга дрейфа.
Для бизнеса персонализация несёт и дополнительный риск. Производственные данные редко бывают готовы к загрузке «как есть»: в них могут находиться персональные данные, коммерческие условия, секреты исходного кода и результаты ошибочных решений операторов. Дообучение нужно связывать с политиками доступа, очисткой наборов данных и понятным способом отката модели. Иначе обещание адаптации к бизнесу превращается в ещё один канал утечки или в автоматизацию старых ошибок.
Фредди ожидает, что быстрые модели уровня «Система 1» будут работать в паре с более медленными рассуждающими LLM — условной «Системой 2». Вероятно, главный спор в этом сегменте развернётся не вокруг того, кто покажет лучший результат в общем тесте, а вокруг того, кто сможет безопаснее и быстрее превратить данные конкретной компании в измеримо более точные решения. Подробнее о позиции Sqwish Labs и реакции рынка можно прочитать в .