Лимит контейнера в один CPU почти вдвое увеличил время обработки 200 записей в .NET: медиана выросла с 42,1 до 83,6 секунды. Причина оказалась не в нехватке процессорного времени, а в том, что параллельный цикл .NET по умолчанию сократил число одновременно выполняемых I/O-задач до одной. Для команд, запускающих бэкенды в Kubernetes и Docker, это неприятный сценарий: без явной настройки ресурсов обычное изменение CPU-лимита способно тихо превратить пакетную обработку в последовательную.
Об этом сообщает Stack Overflow Blog, описавший эксперимент с пятью запусками каждой конфигурации. В обеих версиях контейнер успешно записал все 200 объектов, поэтому проблема не выглядела как инцидент: не было ни ошибок, ни потерянных данных. Менялось только время ожидания. Именно такие деградации легко списать на медленные внешние сервисы, хотя источник задержки находится в настройках конкурентности приложения.
Типичный код выглядит вполне безобидно: Parallel.ForEachAsync(records, cancellationToken, async (record, ct) => await ProcessAsync(record, ct)). Для каждой записи обработчик делает три запроса на обогащение данных, затем записывает результат в основную систему. Однако у Parallel.ForEachAsync без явных параметров максимум одновременных операций привязан к Environment.ProcessorCount. Передача объекта ParallelOptions только с токеном отмены ситуацию не меняет: значение MaxDegreeOfParallelism остаётся равным -1, а для этого API оно снова означает число процессоров.
В Linux и macOS, а в Windows начиная с .NET 6, Environment.ProcessorCount учитывает не только число логических ядер машины, но и affinity процесса и CPU-лимит. Рантайм выбирает наименьшее применимое значение и фиксирует его при старте процесса. Контейнеру дали один CPU — приложение увидит один процессор. Даже лимит в половину CPU после округления вверх даст единицу. В тесте с двумя CPU одновременно обрабатывались две записи, с одним — одна. Важная деталь: явная запись MaxDegreeOfParallelism = -1 не снимает ограничение, хотя код легко прочитать именно так.
Для CPU-bound работы такая логика ожидаема: нет особого смысла запускать сотни вычислительных задач на одном ядре. Но I/O-нагрузка живёт по другим правилам. Пока запрос ждёт ответ API или запись в базу, он почти не занимает CPU. Количество нужных операций «в полёте» зависит от целевой скорости и задержки, а не от доступных ядер. Автор приводит расчёт по закону Литтла: если три вызова обогащения занимают в сумме 360 мс, запись — ещё 30 мс, то для темпа 100 записей в секунду потребуется примерно 39 одновременно обрабатываемых записей. Параллельный цикл .NET, ограниченный одним CPU, пропустит только одну.
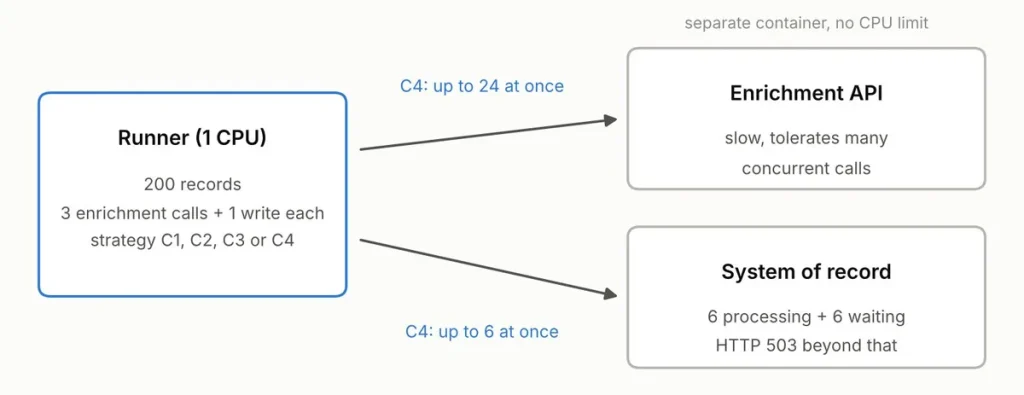
Очевидный ответ — поставить большой MaxDegreeOfParallelism, например 32. Но это лишь переносит риск вниз по цепочке зависимостей. Быстрый API обогащения может спокойно пережить десятки одновременных запросов, а старая система учёта — только шесть. В лабораторной схеме Stack Overflow Blog именно так и было: сервис записи обслуживал шесть запросов, ещё шесть держал в очереди и отвечал HTTP 503 на всё сверх этого. Общий лимит на исходящие вызовы тоже не решает задачу полностью: медленный сервис удерживает разрешения дольше, вытесняя остальные запросы. Пул из 30 разрешений не гарантирует, что в сервис с потолком шесть не уйдёт седьмой запрос.
Практический рецепт — разделить внешний параллелизм и бюджеты зависимостей. Внешний цикл должен держать в работе достаточно записей, чтобы не простаивать на ожиданиях, а каждый downstream-сервис — иметь собственный SemaphoreSlim с понятным лимитом. В примере автора для 32 записей в обработке выделены 24 разрешения на обогащение и шесть на запись. Эти семафоры должны быть общими для всего потока работ, а не создаваться на каждую запись: иначе каждая задача получит персональный лимит и защита исчезнет.
Лимит конкурентности не заменяет rate limit. Семафор ограничивает число незавершённых вызовов, но не соблюдает квоту «запросов в минуту» — в том числе у провайдеров LLM. Нужны два независимых контроля: ограничитель частоты для квот и бюджет одновременных вызовов для защиты сервиса от перегрузки. Тайм-аут запроса также лучше начинать после получения разрешения, отдельно задав дедлайн на ожидание в локальной очереди. Иначе запись может исчерпать сетевой тайм-аут ещё до того, как запрос вообще отправлен.
Когда зависимость замедляется, корректно настроенный бюджет не наращивает давление на неё, а формирует очередь выше по потоку — это нормальный backpressure, но его надо наблюдать. Лимиты стоит выносить в конфигурацию, проверять при старте и сопоставлять с метриками активных вызовов, задержек и отказов. Главный вывод здесь не про выбор «правильного» числа 32: CPU-лимит контейнера не должен неявно определять нагрузку на чужую базу или API. Код эксперимента и заранее зафиксированные гипотезы доступны в ; для production-команд это хороший повод проверить, какие ещё CPU-зависимые значения случайно стали лимитами I/O-конкурентности.