Vera CPU от Nvidia может прибавить до 39% производительности в ресурсоёмких задачах после оптимизации программ под собственную микроархитектуру Olympus. Для команд, рассчитывающих запускать на новых серверах готовый Arm-код без доработок, это важная оговорка: процессор быстр и без тюнинга, но заметная часть его вычислительных блоков иначе останется недогруженной.
Об этом Nvidia рассказала на конференции Supercomputing 2026, сообщает Tom's Hardware. Vera задуман и как самостоятельный серверный процессор, и как хост для стоек Vera Rubin NVL72. Компания делает ставку не на максимальное число ядер на сокет, а на высокую скорость одного потока, пропускную способность памяти и низкие задержки — параметры, которые особенно важны для агентных ИИ-нагрузок и обработки данных.
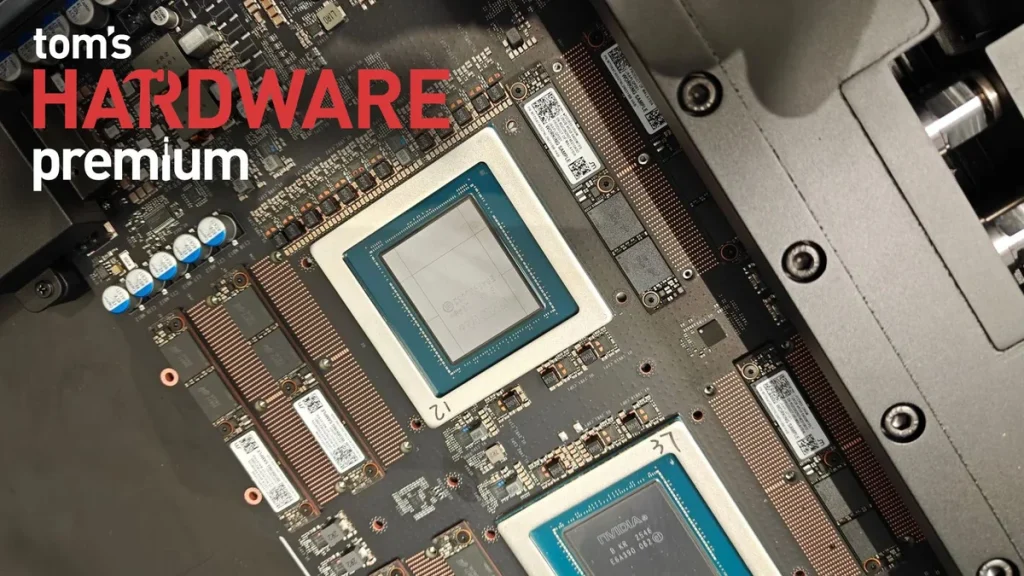
В процессоре установлено 88 универсальных высокопроизводительных ядер Olympus и реализована фирменная spatial multithreading, то есть всего доступно 176 потоков. Предшественник Vera, Grace, использовал готовые Arm Neoverse V2. Olympus — собственная разработка Nvidia: у ядра 10-wide декодер, нейросетевой предсказатель ветвлений, глубокое внеочередное исполнение, шесть векторных исполнительных блоков, четыре конвейера загрузки и два конвейера записи. Всё это дополнено крупными приватными кешами и механизмами предвыборки данных.
Такой набор ресурсов сам по себе не гарантирует пропорционального ускорения. Главная демонстрация Nvidia построена на DGEMM — умножении матриц двойной точности — с ассемблерным ядром из OpenBLAS. Исследователи использовали задачу 128 × 128, которая целиком помещается в кеш L1 обоих процессоров. Это не универсальный бенчмарк дата-центра, зато он хорошо показывает, насколько код умеет кормить векторные блоки инструкциями.
От 20% без тюнинга до 67% с ним
С ядром OpenBLAS, рассчитанным на Neoverse V2, Grace показал 4,51 инструкции за такт и 13,03 операции FP64 за такт. Vera на том же коде достиг 5,43 IPC и 15,69 FP64-операции за такт — примерно на 20% больше. Уже неплохо: переносимость Arm-софта работает. Но специальное ядро для Olympus подняло результат Vera до 7,53 IPC и 21,75 FP64-операции за такт. Относительно варианта без адаптации это почти 39%, а преимущество над Grace в этом конкретном тесте достигло почти 67% на ядро и такт.
Причина довольно приземлённая. У Neoverse V2 четыре 128-битных SIMD-конвейера, способных выполнить до 16 FP64-операций за такт. Olympus располагает шестью такими блоками и теоретическим пределом в 24 операции — на 50% выше. Однако старое ядро OpenBLAS использует около 81,4% пикового FP64-потока Grace, но лишь около 66,5% возможностей Vera. После перестройки тайлов матриц, распределения регистров и расписания инструкций загрузка Olympus выросла до 90,6% от пика.
Для разработчика вывод знакомый по x86-миру: совместимость ISA не отменяет архитектурной специфики. Компилятор, библиотека и приложение могут корректно работать на новом сервере, но не обязаны эффективно использовать его ширину исполнения, кеши и подсистему памяти. Особенно это касается BLAS-библиотек, инференс-рантаймов, баз данных, аналитических движков и других компонентов, где несколько процентов производительности превращаются в дополнительные серверы или, наоборот, позволяют их не покупать.
Nvidia не скрывает и границы позиционирования. Руководитель маркетинга Vera Ханна Кутанд прямо сказала Tom's Hardware, что процессор не предназначен для общих задач вроде типового веб-сервера в облаке: для них могут существовать более подходящие варианты. Vera рассчитан на нагрузки, которым критичны высокая производительность ядра, широкая память и низкая латентность. Это разумная специализация, но она делает программную экосистему ещё важнее: покупатель должен понимать не только паспортные характеристики CPU, но и готовность своего стека к Olympus.
CPU-рынок упирается в экосистему
Для Nvidia это следующий сложный этап после проектирования кремния. Компания десятилетиями выстраивала вокруг CUDA инструменты, библиотеки и работу с партнёрами. Теперь похожая дисциплина потребуется Vera CPU: поддержка в OpenBLAS и других критичных библиотеках, профилирование, качественные компиляторные настройки и понятные рекомендации для разработчиков. Intel и AMD давно проходят этот путь с оптимизированными математическими библиотеками и настройкой кода под поколения процессоров; Nvidia придётся убедить рынок, что её стек не уступает в зрелости.
Пока цифра «до 39%» относится к специально подобранному матричному микротесту, а не к среднему ускорению любых приложений. Самый интересный вопрос — повторится ли эффект в реальных агентных ИИ-системах, обработке данных и корпоративных сервисах с их памятью, сетью и смешанными профилями нагрузки. Если да, Vera CPU станет не просто обязательным сопровождающим чипом для GPU-стоек Nvidia, а заметным аргументом на самостоятельном серверном рынке. Детали эксперимента и позиционирования Nvidia приведены в материале .