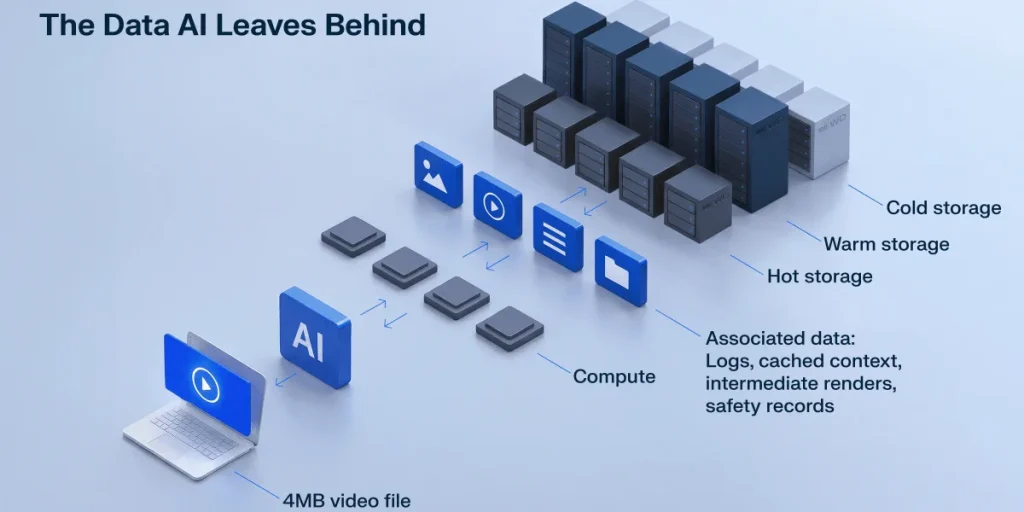
8-секундный ролик, который пользователь получает как файл на 3,97 МБ, способен оставить в инфраструктуре более 500 МБ служебных и промежуточных данных. Эта разница в 130 раз превращает хранение данных ИИ из незаметной строки сметы в потенциально дорогую проблему для компаний, которые масштабируют генеративные сервисы. Для российских команд это повод считать стоимость AI-продукта не только по GPU-часам и API-запросам, но и по всему следу, остающемуся после каждого ответа модели.
Об этом сообщает MIT Technology Review в спонсорском материале, подготовленном компанией WD. Авторы предлагают посмотреть на инфраструктуру ИИ не со стороны обучения моделей, а со стороны инференса — постоянного потока запросов, генераций, журналов и копий данных. Именно он работает без финальной даты проекта: обучение можно завершить и выключить кластер, а пользовательские запросы продолжают приходить каждый день.
В измерениях WD один короткий AI-ролик породил не только финальный файл. В бэкенде остались логи, закешированный контекст, промежуточные рендеры, резервные копии и записи, связанные с проверками безопасности. Компания не раскрывает методику этих измерений и не называет конфигурацию сервиса, поэтому цифру нельзя переносить на любой видеогенератор. Но сама пропорция хорошо показывает, почему размер скачанного файла почти ничего не говорит о реальном объёме данных в инфраструктуре.
Особенно быстро этот эффект проявится в видео: длина роликов и разрешение растут, а за ними увеличивается объём временных артефактов и материалов, которые бизнес по разным причинам не спешит удалять. У ритейлера это могут быть варианты товарных роликов, у страховой компании — документы, результаты извлечения данных и контекст для RAG-системы. Вычисления здесь относительно легко привязать к одной генерации или обработанному обращению. Данные же копятся с каждой операцией и остаются в системе после завершения задачи.
Инференс копит данные быстрее, чем заканчиваются проекты
Разница между обучением и инференсом важна для бюджетирования. Обучение обычно имеет границы: команда запускает эксперимент, потребляет вычислительные ресурсы и фиксирует результат. Инференс — это эксплуатационный процесс. Каждый ответ чат-бота, сгенерированное изображение, транскрибированный звонок или фрагмент видео может создавать набор технических данных, нужных для отладки, безопасности, повторного использования или выполнения внутренних правил хранения.
По приведённому в материале прогнозу McKinsey, спрос на AI-инференс до 2030 года будет расти со среднегодовым темпом 35%, тогда как для обучения ожидается 22%. К концу десятилетия инференс может сформировать более 40% совокупного спроса со стороны дата-центров. Это не прогноз конкретно для российского рынка, но направление понятно: по мере перехода от пилотов к продуктам расходы будут смещаться от разовых запусков моделей к постоянно работающей инфраструктуре.
Опрос IDC, проведённый при поддержке WD среди 763 IT- и бизнес-руководителей, добавляет ещё один штрих. Почти 95% респондентов сообщили, что за последние 12 месяцев генеративный ИИ увеличил объём их данных; около 61% указали рост не менее чем на 25%. Это результаты исследования, финансируемого поставщиком накопителей, поэтому их стоит читать как сигнал о проблеме, а не как независимую оценку всего рынка. Тем не менее сам сценарий знаком многим командам: пилот запускается на ограниченном наборе данных, а затем появляются история диалогов, логи качества, резервные копии, векторные индексы и новые требования к хранению.
Узким местом становится не только ёмкость. В цитате, приведённой в материале, менеджер гиперскейл-облака отмечает, что накопители помогают не оставлять GPU без работы в ожидании данных: часы простоя ускорителей быстро обходятся дорого. Одновременно 96% участников того же опроса ожидают, что им потребуется более быстрое извлечение из архивов для инференса или RAG. Архив перестаёт быть кладбищем старых файлов: данные из него могут вновь оказаться в контексте модели, поисковой выдаче или проверке результата генерации.
Что проверить до следующего масштабирования
Для разработчиков это означает, что observability и политики ретенции нельзя оставлять «на потом». Полезно отдельно учитывать размер исходных запросов, контекста, промежуточных артефактов, логов и резервных копий; иначе финансовая картина будет состоять только из заметных счетов за ускорители. Продактам и IT-директорам стоит связать срок хранения с задачей: часть данных нужна для расследования инцидентов или улучшения качества, часть — лишь несколько часов для повторной попытки генерации. Одинаковая бессрочная ретенция для всех артефактов — дорогой способ избежать разговора о владельце данных.
Архитектура тоже требует разделения на уровни. Горячие данные для активного инференса и индексов требуют быстрой выдачи, но основной объём может жить в более ёмких и дешёвых слоях. Выбор между SSD, жёсткими дисками и архивным хранением зависит от профиля доступа, требований к восстановлению, энергопотребления и надёжности, а не от модного названия технологии. Важно заранее проверить, не создаёт ли каждая новая функция ИИ несколько дополнительных копий одних и тех же данных в пайплайнах, очередях, хранилищах объектов и системах аналитики.
Главный вопрос для бюджета звучит неприятно просто: если использование ИИ вырастет вдвое, во сколько раз вырастет хранение данных ИИ? Ответ «примерно вдвое» уже требует подтверждения метриками; на практике рост могут ускорить резервирование, дублирование, требования безопасности и повторное использование данных в RAG. Компании, которые посчитают этот след до расширения AI-сервисов, смогут выбирать, что хранить и на каком уровне, а не обнаруживать проблему в момент, когда GPU уже куплены, а счёт за инфраструктуру продолжает расти.