FADU представила SSD, который принимает файловые запросы без участия файловой системы хоста и блока хранения: в предварительном NFS-тесте накопитель удерживал около 460 тыс. операций в секунду при сокращении сервера с 16 ядер до одного. Файловая система в SSD может снять заметную часть нагрузки с CPU в GPU-кластерах, DPU-серверах и будущих массивах JBoF — сценариях, которые уже интересны и российским командам, строящим инфраструктуру для ИИ и высоконагруженных сервисов.
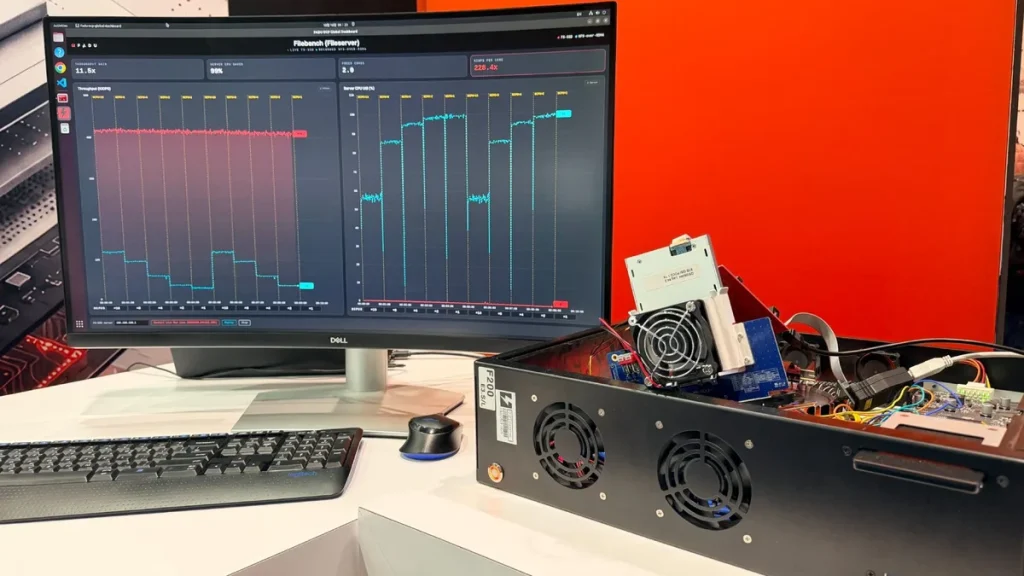
Разработчик контроллеров FADU из Южной Кореи показал File-Semantic SSD, или FS-SSD, на саммите OCP Global Summit 2026, сообщает Tom's Hardware. Идея проста по формулировке и непроста по реализации: GPU, DPU либо сетевой адаптер должны уметь открыть и прочитать файл напрямую, не прогоняя запрос через CPU сервера, ядро ОС, обычный блочный слой и отдельный storage-сервер. Накопитель сам разбирает путь к файлу, проверяет права и сопоставляет файл с физическими страницами флеш-памяти.
Это попытка закрыть неприятный разрыв между быстрым каналом данных и медленным управляющим контуром. Ускорители уже давно умеют получать большие объёмы данных по прямым путям вроде GPUDirect Storage, но смысл файлов — каталоги, имена, метаданные и права доступа — обычно остаётся на стороне хоста. По оценке FADU, файловая система вместе с блочными слоями способна забирать примерно 30% процессорных циклов в нагрузке случайного чтения через GDS. Обход этих слоёв экономит CPU, но часто превращает работу с данными в доступ к «сырым» блокам. FS-SSD обещает оставить привычную файловую модель и убрать посредника.
Для этого FADU использует компактный и stateless-протокол NFSv3: его 21 операция передаются внутри стандартных NVMe-команд. Нового транспорта компания не требует: заявлена работа по PCIe, а для сети — через NVMe-oF поверх RDMA и TCP. В демонстрационном тесте NFS поверх NVMe накопитель на контроллере FC6161 Gen6 сохранял примерно 460 тыс. операций в секунду при переходе от 16 серверных ядер к одному. Для сравнения, Linux NFS-over-RDMA в тех же материалах FADU показал около 150 тыс. операций в секунду на 16 ядрах и порядка 40 тыс. — на одном. Это цифры производителя, а не независимый бенчмарк, но сам профиль результата показателен: устройство пытается сделать серверный CPU почти необязательным для пути к данным.
Внутри объединены слой файловой системы, основанный на F2FS, и обычный для SSD слой трансляции адресов флеш-памяти. Узлы и блоки данных привязаны к естественному размеру страниц NAND, а таблица узлов F2FS превращается в File Map с физическими адресами. Такой подход, по расчётам FADU, не требует больше DRAM, чем обычный накопитель: около 0,1% ёмкости NAND, или приблизительно 1 ГБ на 1 ТБ. Но если стандартный SSD тратит почти всю эту память на таблицу отображения, FS-SSD может отдать около 95% под горячий кэш метаданных. Заодно вместо двух уборщиков мусора — файлового и внутреннего SSD — остаётся один; компания заявляет на 63% меньшую write amplification в смешанной последовательной и случайной нагрузке относительно host-F2FS.
Предварительные результаты fio выглядят менее магически и потому полезнее. В системе с PCIe 5.0 хостом последовательное чтение у всех конфигураций упёрлось примерно в 14,1 ГБ/с — предел линии, а не накопителя. FS-SSD с клиентом ядра выдал 11,94 ГБ/с на последовательной записи против 7,05 ГБ/с у Ext4. В случайных операциях блоками по 4 КБ картина сложнее: kernel-клиент FS-SSD показал 8,07 ГБ/с на чтении и 4,32 ГБ/с на записи, уступив Ext4 с 9,12 и 4,56 ГБ/с соответственно. С пользовательским SPDK-клиентом FS-SSD достиг 13,0 ГБ/с при случайном чтении и 7,03 ГБ/с при записи, но «сырой» блочный доступ через SPDK всё равно быстрее — 13,99 и 13,24 ГБ/с. За удобство файловой семантики приходится платить, особенно на записи.
Есть и более важные вопросы, чем разница в процентах. NFSv3 статeless, а значит FS-SSD не реализует межхостовую блокировку: если два клиента пишут в одно место, выигрывает последняя операция. Клиенты с kernel mount полагаются на обычные рекомендательные блокировки, а GPU- и SPDK-клиенты должны договариваться на уровне приложения; в масштабных конфигурациях эту роль предполагается отдать pNFS metadata server. Кэширование тоже не становится автоматически согласованным: оно работает как в обычном NFS для клиентов ядра, а у GPU и SPDK его может не быть вовсе. Для базовой аутентификации FADU описывает capabilities, выдаваемые внешним сервером, и планирует Kerberos, но ACL, снапшоты и квоты в текущем варианте не заявлены. Шифрование обеспечивается штатной поддержкой TCG Opal контроллера FC6161.
Первым практическим полем для файловой системы в SSD станут чтение датасетов и чекпойнтов GPU, HTTP-раздача через DPU и файловые JBoF-массивы без классического сервера перед дисками. Пока это не готовый продукт: часть тестов с write amplification проведена на программном эмуляторе NVMeVirt, а результаты контроллера Gen6 получены в PCIe 5.0 хосте. FADU ждёт тестов с PCIe 6.0 хостом к первому кварталу 2027 года и партнёрских образцов в третьем квартале. К концу 2027 года компания рассчитывает подготовить эталонный JBoF с DPU Xsight Labs. Ключевой экзамен для идеи — не пиковые IOPS, а совместимость, безопасность и предсказуемое поведение при конкурентной работе ускорителей. Если их удастся довести до производственного уровня, файловая система в SSD станет не экзотикой контроллера, а ещё одним способом вернуть CPU серверу его основную работу. Подробности архитектуры и методики FADU опубликованы в материале .